软件信息
软件介绍
下载君是一款网友原创的看图下载工具,能够自动发现并抓取美女图片,作为通用的图片下载器,它可以识别网址并筛选出想要的图片,支持免费保存。
工具简介
我的原则是,你只需提供一个网址,其余工作由我完成。
下载君可以下载美女图、壁纸、头像等各类图片,只要是图片资源,都尽量支持下载,是一款具备一定通用性的图片获取工具。
下载君会自动探测所提供网址所在站点的页面,不会访问站外链接。
下载君操作指南
访问深度:不宜设置过大,因为该参数呈指数级增长,例如设为3,就可能发现数千个新页面(具体数量因网站而异)。
图片线程:同样不宜过高,够用即可,过高会对网站造成压力,还可能因访问频率过高而被封禁,得不偿失。应追求稳定而非速度。
工具只需正确设置网页元素的xpath即可顺畅运行,所以下面重点说明如何正确使用xpath。
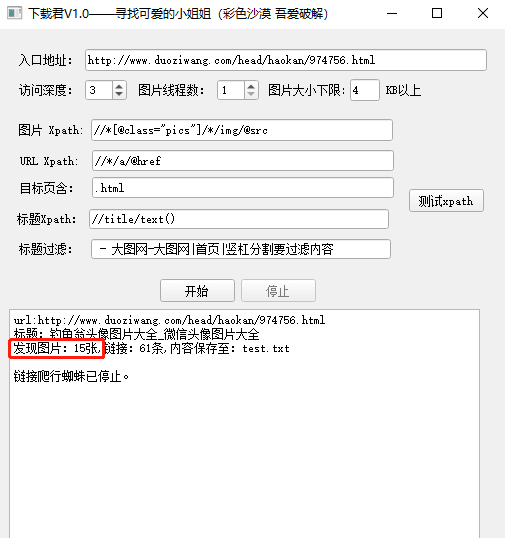
用 Chrome 访问页面后,所需正文图片共有 15 张,其余图片不属于目标范围。
在目标图片上点击右键,选择“检查”,打开开发者工具的元素面板:
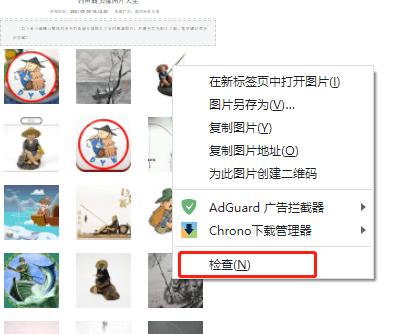
在选中的元素上,右键菜单依次点击Copy > Copy XPath,如图所示:
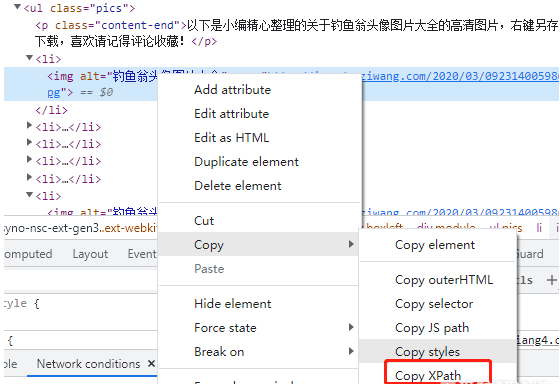
复制后得到这样一条xpath
//*[@id="syno-nsc-ext-gen3"]/div[3]/div[3]/div[1]/div[1]/ul/li[7]/img
可以看出它按照html层级逐步定位到该img元素,如果我们需要匹配所有图片元素,该如何处理?
我们往上一级查看,图片在
中,而
- 中有2个
,图片所在的
是第一个。
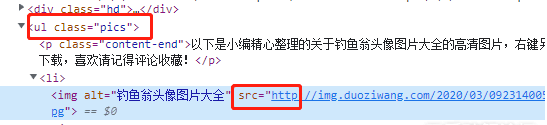
因此,对xpath进行修改
//*[@class="pics"]/*/img
其含义是查找带有 pics 类名的元素内部的所有 img 标签。开头的*和结尾的*代表任意层级。
定位到元素后,需要获取其src属性值(即图片地址),所以图片的xpath最终修改为:
//*[@class="pics"]/*/img/@src
进行测试,成功找到15张图片,结果如下
标题部分可保持默认,会抓取整个网页的标题,配合“标题过滤”可去除部分通用文字;若需更精确,则应准确定位到主标题。
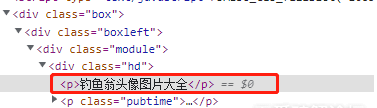
如上所示,标题所在的元素是
,位于
内的文本,因此要添加text()方法,最终xpath如下:
//*[@class="hd"]/p[1]/text()
更新记录
1、支持设置爬虫访问深度。
2、支持设置图片下载线程数。
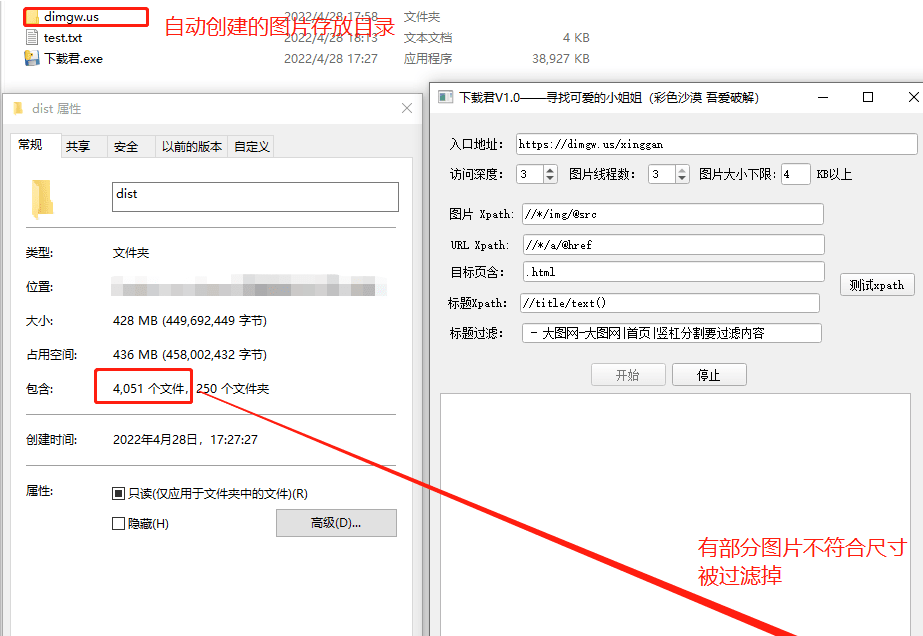
3、支持按图片尺寸进行过滤。