软件信息
软件介绍
这款漫画下载器提供免费无广告版本,用户可以在电脑上直接获取各大漫画网站的漫画。只需粘贴目标漫画的网址,软件会自动解析并快速完成下载。
漫画下载器功能简介
该软件通过爬虫技术提取漫画章节信息,并依据章节链接抓取漫画图片。它利用XPath表达式定位内容,熟悉XPath的用户能快速上手;不熟悉的用户可借助浏览器辅助功能获取路径,软件内置优化功能便于过滤无用部分,但相关浏览器技巧需自行学习。软件支持收录常用网站,一旦通过XPath测试收录,该站所有漫画即可通过简单操作下载。
下载完成后,图片可打包为压缩文件或ePub电子书,还能制作不含图片的在线ePub电子书。在线电子书无需下载图片,只需解析章节中的图片链接即可生成,体积小巧。注意:阅读设备需具备联网功能,无WiFi时会消耗流量。
目前,正规漫画网站普遍采用HTML加密,爬虫难以直接下载图片。不过,仍有一些非正规网站未加密,用户可以尝试,但不建议去尝试知名大型漫画网站,以免失败。
漫画下载器主要特色
通过自定义XPath路径抓取漫画,网站规则定义后可收录,方便后续下载更多漫画。
利用浏览器的无障碍特性取得XPath路径,再经过工具调整获得所需的XPath表达式。
获取的漫画能够打包为 ZIP 压缩文件或 ePub 电子书。
能够生成不含图片的网络 ePub 电子书,文件大小较小(通常在 2MB 以内)
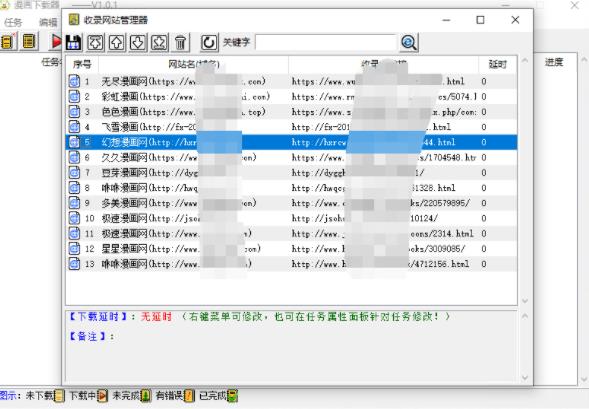
内置多个收录网站,无需手动定义规则即可直接下载。
漫画下载器使用指南
1、可以按个人需要设置下载的规则
首先在浏览器中打开漫画的目录页,复制其链接。
然后在软件中新建任务,粘贴复制的链接。
通过浏览器取得 XPath 表达式(具体操作可自行搜索)。
把 XPath 路径粘进去再进行调优,核心是明确目录页里“章节名称”和“章节链接”,以及章节页内“图片链接”这三类规则的写法;如果计划收录整个站点,最好再把漫画名称也配置上。
在测试确认没有问题之后(也就是可以在漫画图片分析列表里正常预览到漫画画面),再建立任务。
最后等待任务下载完成。
2、自所列站点获取漫画资源
启动“收录网站管理器”,从列表里挑选一个收录站点,然后点击右键菜单里的“打开网站首页”命令。
该程序会调用浏览器访问目标站点,浏览并定位到包含所需漫画的章节列表页面,然后把该列表页的地址粘贴到“创建任务”界面的指定输入框内。
点击旁边的【查询】按钮即可应用相应规则,对章节进行测试和筛选之后,就可以新建任务。
更新日志
V1.1.0
新增生成XPath路径功能,可根据页面关键字生成XPath表达式,无需再依赖浏览器开发者工具。
主窗口和任务属性面板中加入了用以快速选择的按键:组合键 Ctrl + A 可全选,Ctrl + Shift + A 用来选取未完成的任务,而 Esc 键则用于取消现有选择。
修复若干BUG。
版本 V1.0.1 提供以下更新:优化了界面显示,修复了部分已知问题,并提升了运行稳定性。
修复若干BUG,包括下载进度显示超过100%以及下载图片出错时暂停等问题。
用户无需担心新版本数据覆盖自己收录的网站。新版数据采用备份库,下载新版后直接解压到原目录,运行时若未检测到原版数据,会自动将备份库重命名为正常库,确保直接使用新版的用户也能保留收录的网站。